Seeing without Looking: Do Vision-Language Benchmarks Really Test Vision?
https://arxiv.org/pdf/2605.22903
논문 스터디에서 리뷰한 논문을 간단하게 정리해둡니다..
사실 Vision transformer 연구들에서 후반 레이어들의 토큰은 거의 비슷하다 뭐 이런 연구결과들이 많았는데 그걸 VLM에 적용해본것 같습니다..
Abstract 간단 정리
[Motivation]
VLM이 벤치마크 점수가 높으면 이미지를 잘 이해한다 하는데 실제로 그런지 불분명
이미지토큰의 75%가량 제거해도, 성능은 3%밖에 저하되지 않음
원인은 중복성, 쉬운 벤치마크, 언어 편향 등의 원인이 존재
[Method]
전체 이미지 저하, 국소 가림, 질문 재형식화, 답변 공간 확장, 의사결정 분석, 레이어별 비전 토큰 기하학 분석
[Insight]
VLM이 시각 입력을 활용하긴 하지만, 세밀한 시각 증거 손실에 훨씬 덜 민감하다. 최종 예측이 유지되어도 내부 확신은 이미 약해져 있을 수 있다. 또한 깊은 레이어에서 비전 토큰 간 유사도가 증가하는데, 이것이 그 원인일 수 있다.
[conclusion]
현재 벤치마크는 VLM의 세밀한 시각 이해 능력을 신뢰성 있게 평가하기에 부족
Section 4: Experiment Settings 간단 정리
벤치마크 4종
벤치마크 역할
| POPE | 메인. Yes/No 객체 할루시네이션 테스트 |
| A-OKVQA | 현상이 다른 벤치마크에서도 나타나는지 확인 |
| MME | 현상이 다른 벤치마크에서도 나타나는지 확인 |
| AMBER | 자유 생성 형식에서의 보완적 관점 |
모델 7종
크기와 구조가 다양한 오픈소스 VLM을 사용해서 특정 모델에만 국한된 현상이 아님을 검증했습니다.
LLaVA-1.5-7B / Qwen3-VL-4B, 8B, 32B / Gemma-3-12B / InternVL3-8B / Molmo-7B
평가 지표 요약
실험 종류마다 단순 정확도 외에 다른 지표를 씁니다.
실험 지표
| 일반 정확도 | Accuracy ↑ |
| 개체 마스킹 | Yes Rate ↓(yes라고 대답한 비율, 개체를 마스킹하기 때문에 rate 감소해야함) / Decision Margin Δ |
| Unknown 옵션 추가 | Unknown Rate(불확실한 경우 선택) |
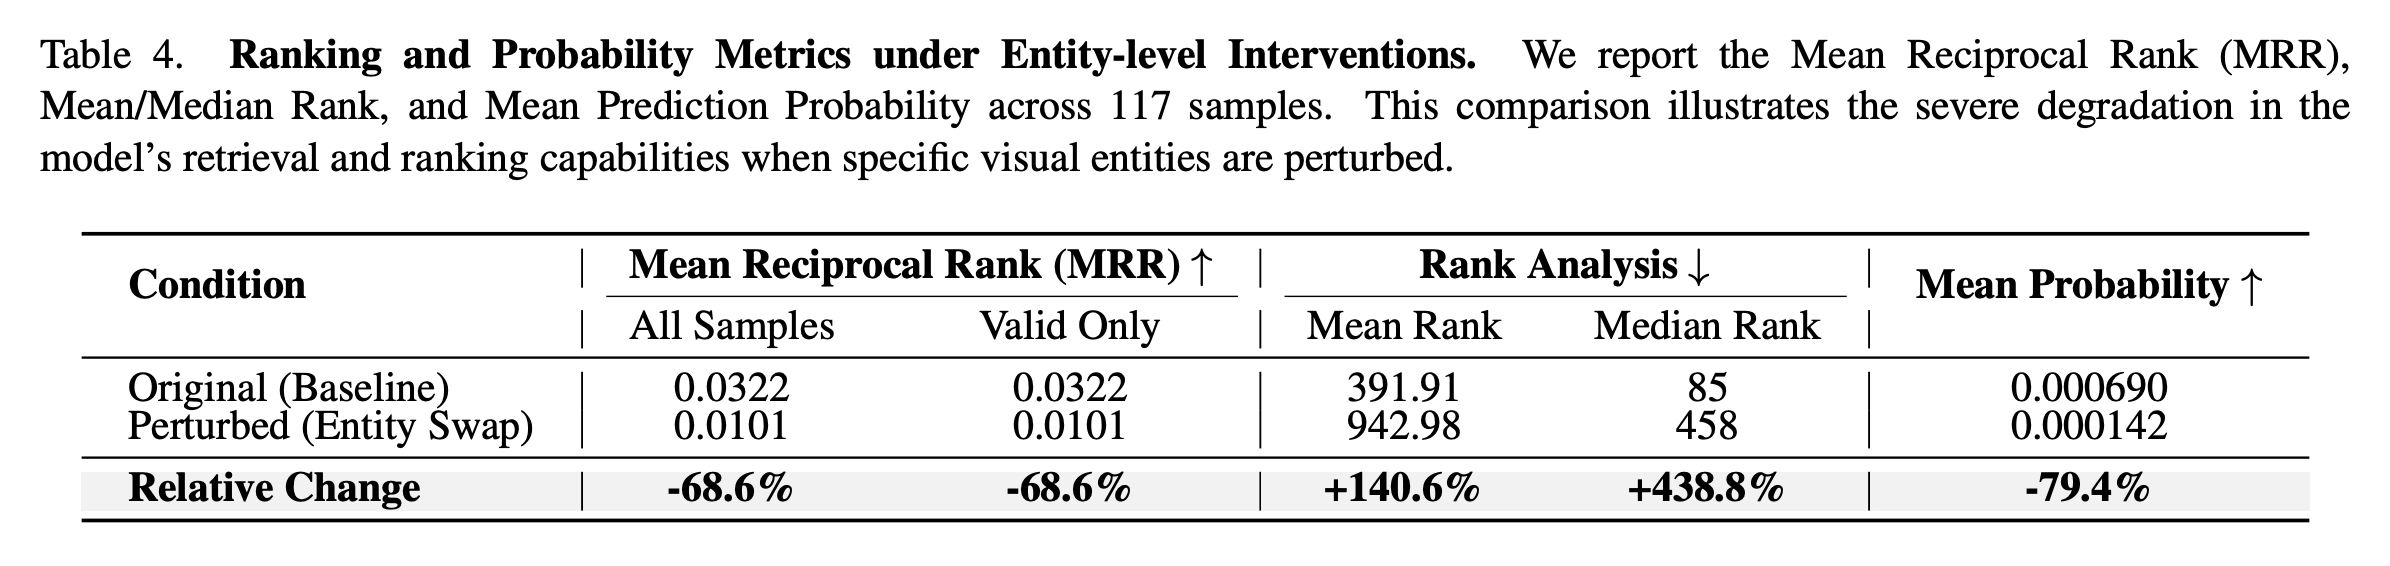
| 개방형 생성 | Entity Rank ↓(정답 개체 몇번째 증가하는지) / MRR ↑(정답 개체가 나왔을때 몇번째로 나왔는지 비율의 전체 평균), 정답이 앞에 나올수록 높아짐) |
| AMBER | CHAIR ↓ (없는걸 있다고 한 비율, 여러개 중 몇개?)/ Hallucination ↓(없는 걸 있다고 했을때) / Coverage ↑(실제 있는 걸 말한 비율) / Cog ↓(그럴법한 착각 e.g. 공원에 꽃 이미지) |
Section 5 Diagnosing Visual Grounding
시각적 수준에서는 이미지 입력에 structured degradation을 가함/ 텍스트 수준에서는 질문과 선택지 변형
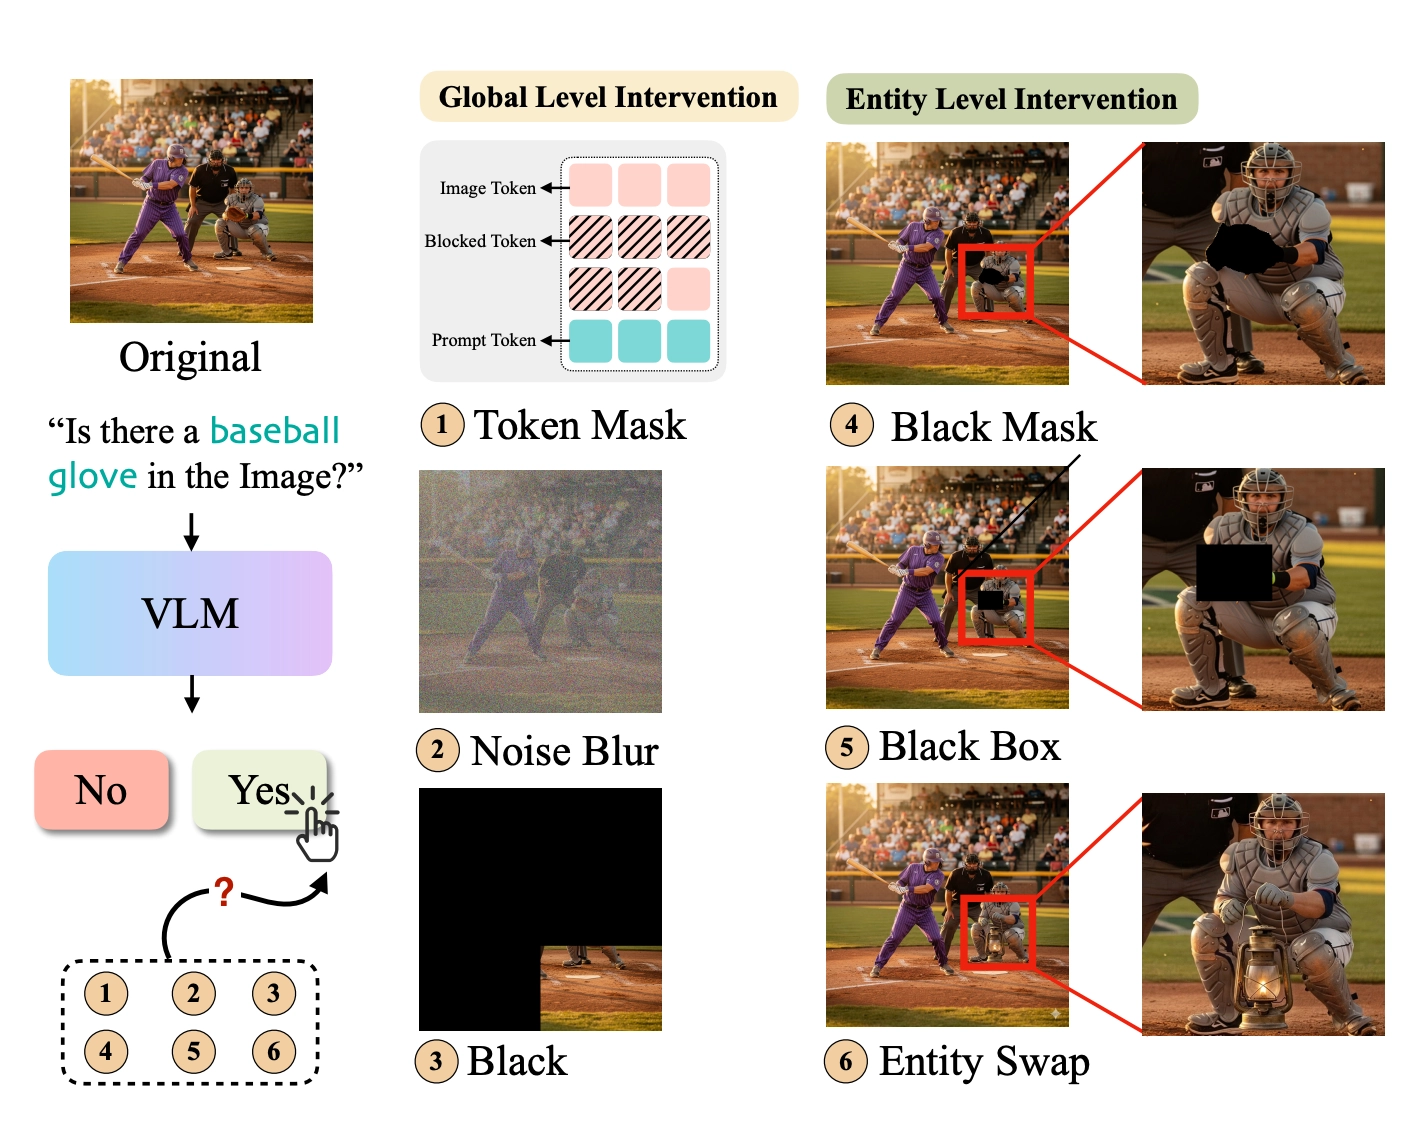
📌 5.1 전체 수준 시각 개입 (Global-Level Visual Interventions)
[실험 설계]
- no-image : 이미지 아예 제거
- Black : 이미지 일정 비율을 검은 마스크로 가리기
- Blur : 원본이미지 + 랜덤 노이즈
모델 성능이 fine-grained visual evidence에 의존한다면, 정확도는 심각도에 비례해 저하되어야함
[결과]
- No image의 경우 랜덤 수준 = “모델이 시각 입력과 완전히 무관하진 않음”
- Black, Blur 조건 심각도에 의해 정확도 저하가 불균형적으로 작음/3개 벤치마크, VLM모델 전반의 일관된 결과
⇒ accuracy와 true visual dependence 간의 간격 존재

📌 5.2 개체 수준 개입 (Entity-Level Interventions)
[실험 설계]
global level intervention으로 모델이 질문과 관련된 특정 시각증거에 의존하는지 알 수 없음 ⇒ Entity-level interventions
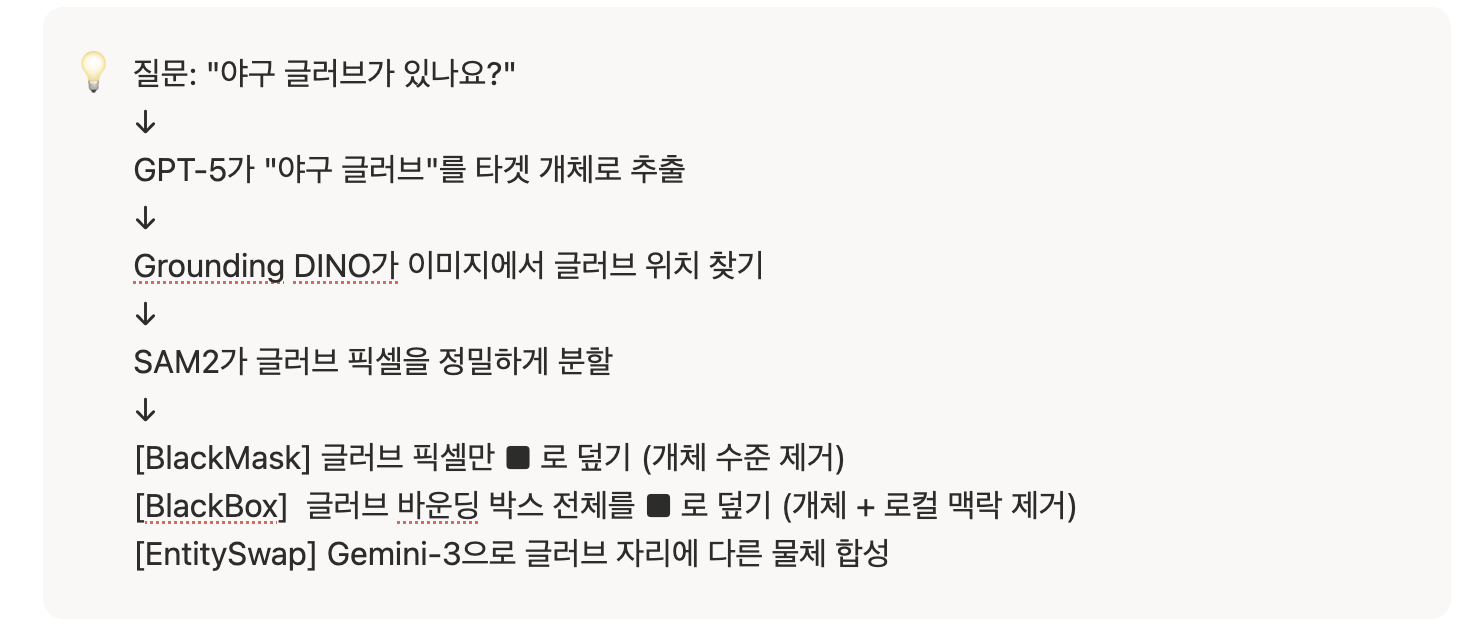
[결과]
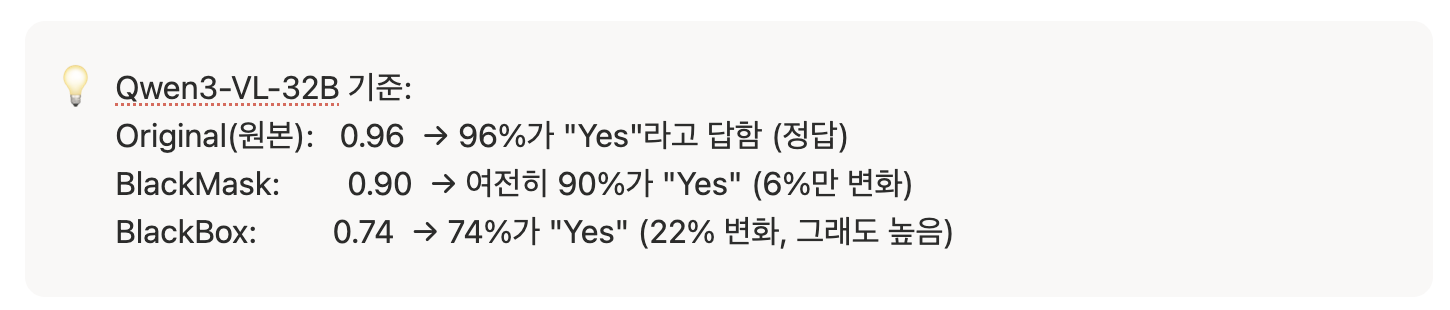
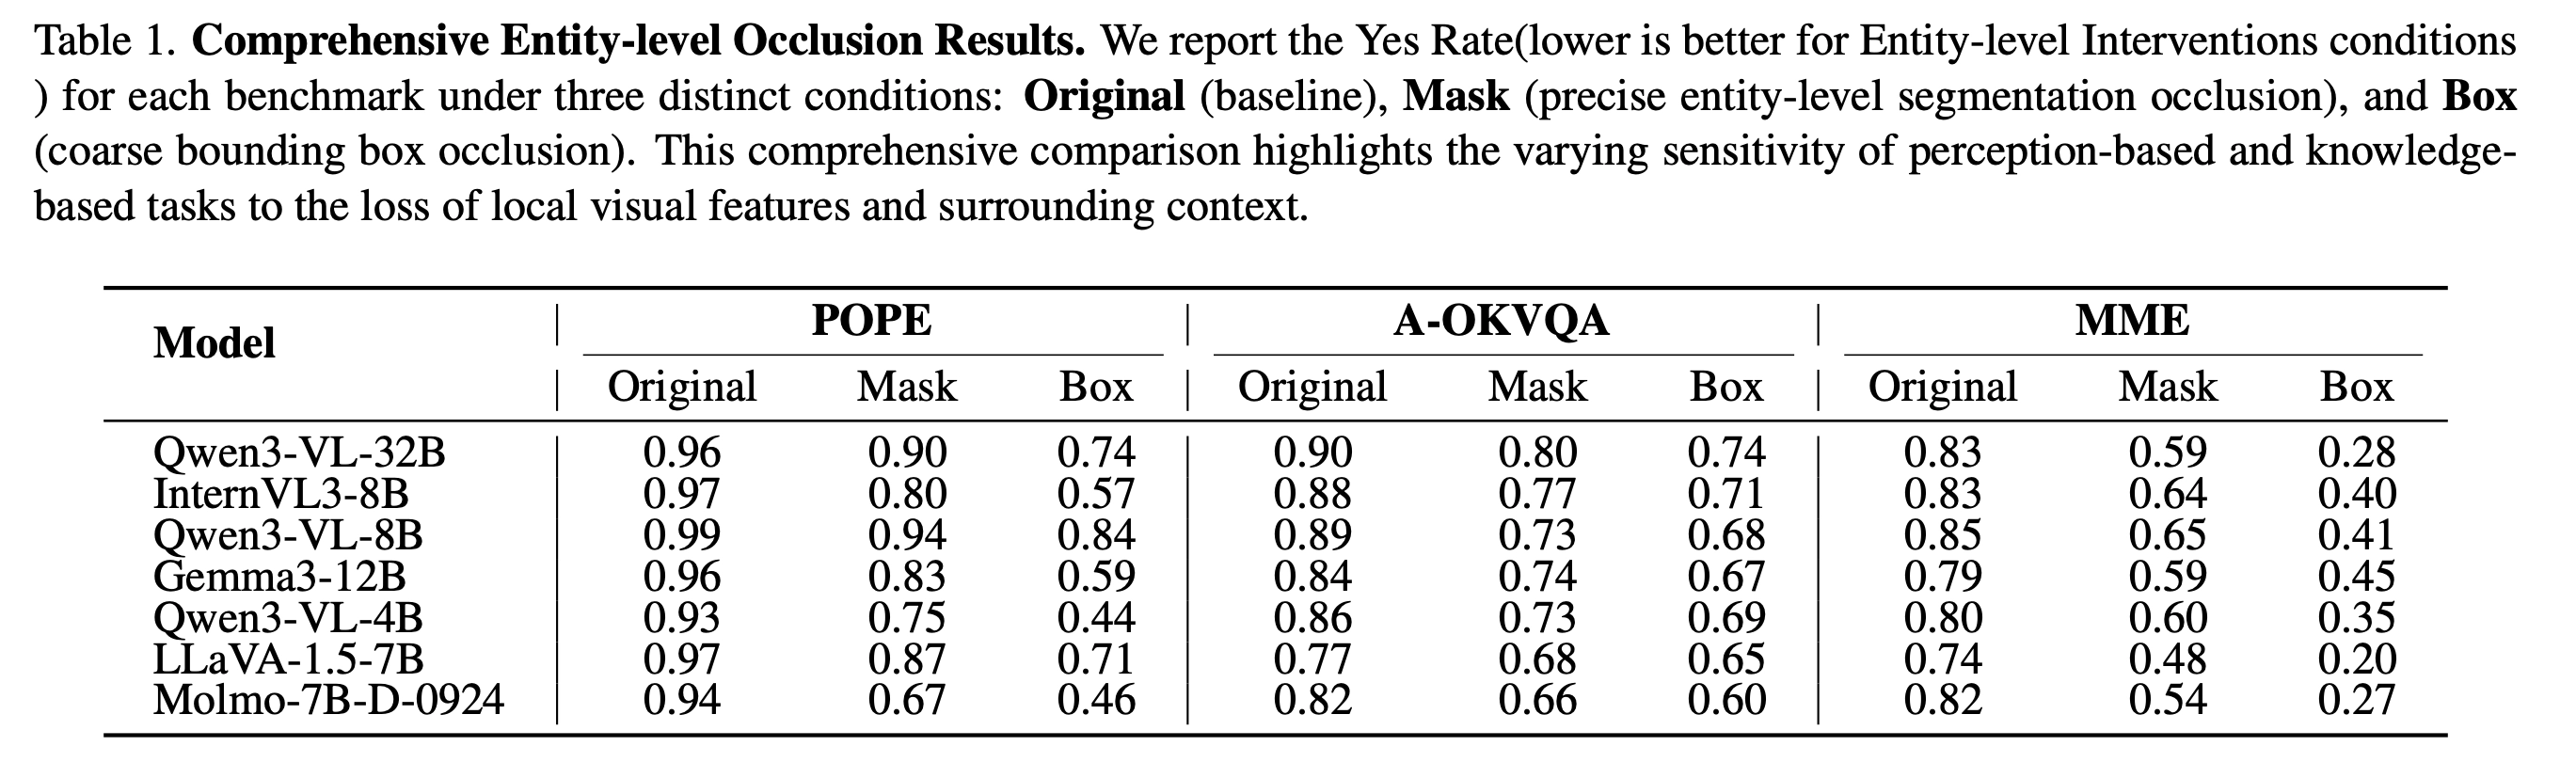
- BlackMask & BlackBox 모두 Yes Rate 감소 ⇒ 모델이 질문과 관련된 로컬 시각 증거에 의존함
- BlackBox가 BlackMask보다 일관된 감소 야기 ⇒ 타겟 entity+surrounding context(silhouette) 제거
- BlackMask하에서도 대부분 모델 POPE에서 높은 Yes Rate 유지 → 주변 맥락만으로 정답을 유지하기 충분할 수 있음
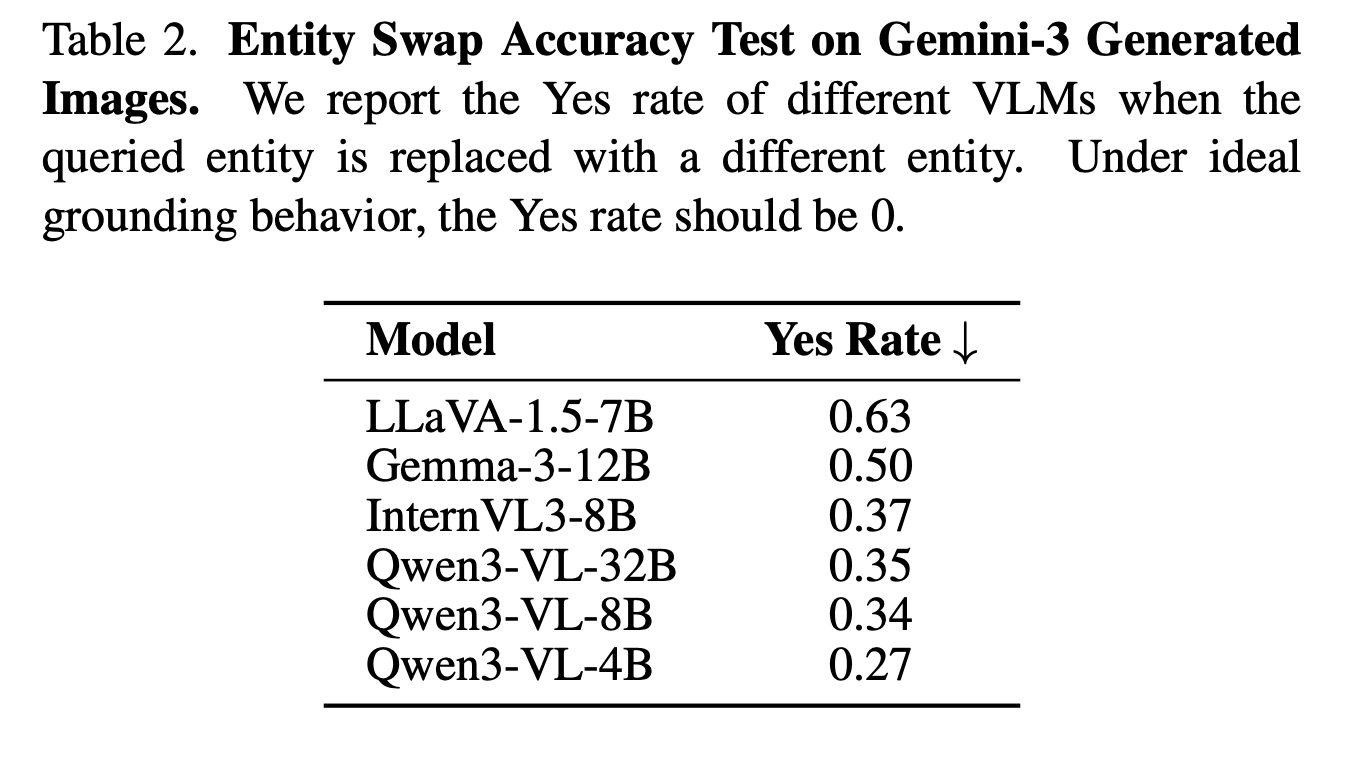
- EntitySwap 은 질의된 개체를 관련없는 물체로 교체 → 더 강력한 counterfactual test ⇒ 항상 정답은 NO + 이상적인 Yes Rate 0
- 그러나 실험 결과는 다음과 같음 ⇒ 이미지를 업데이트하는게 아닌 맥락에 대한 bias가 존재
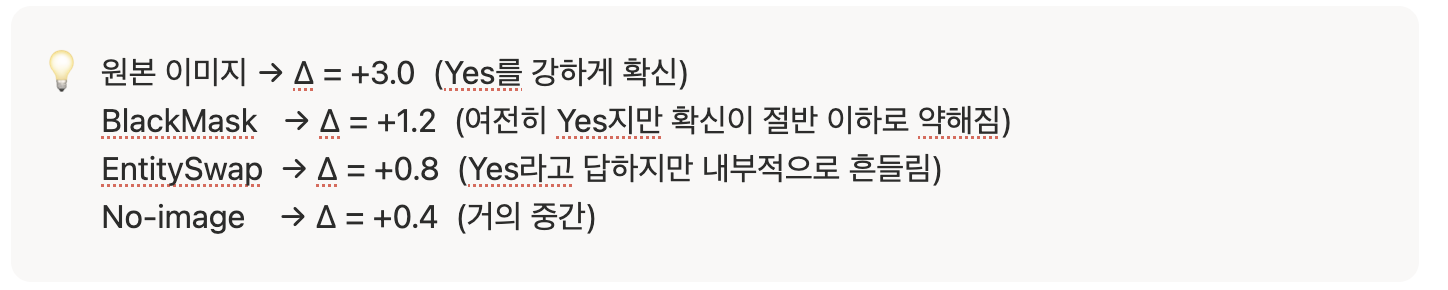
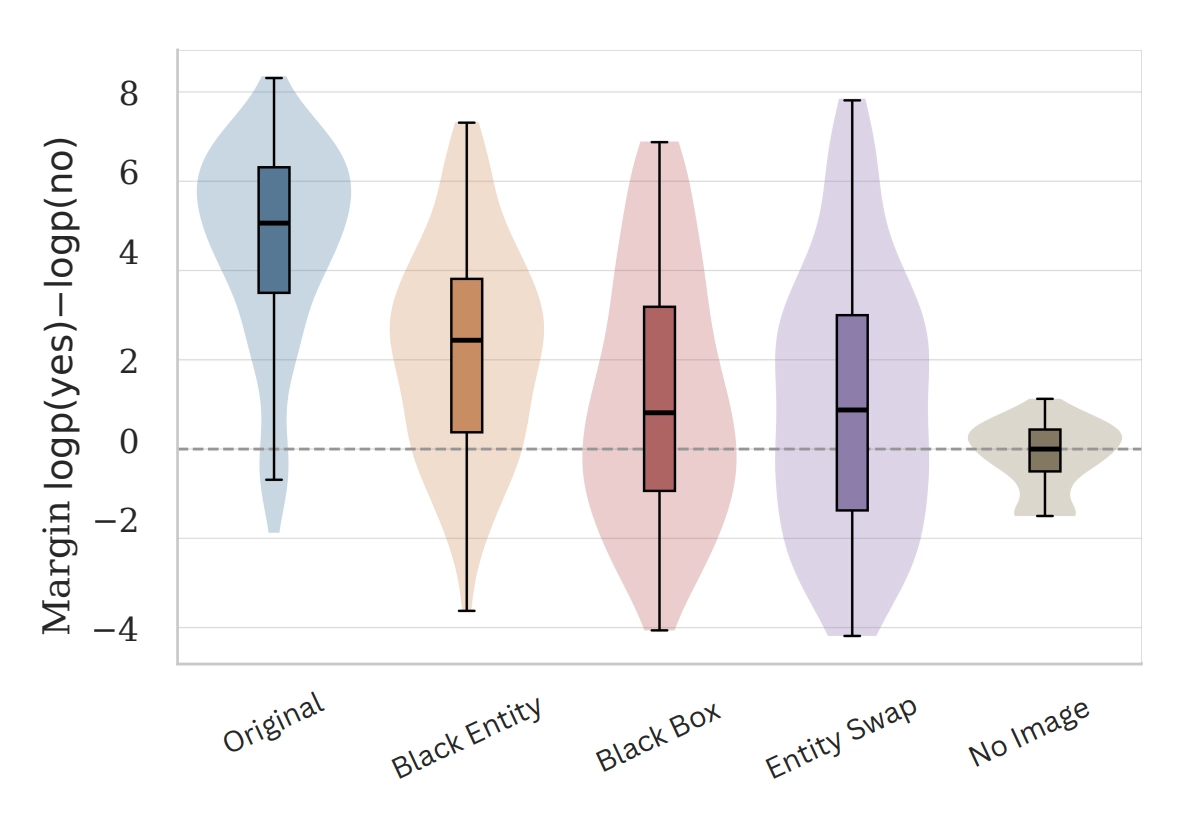
- Decision Margin Analsysis 얼마나 확신했는가
- EntitySwap 이 No-image보다 Yes쪽에 치우침
- 이미지에 글러브를 아예 없앤 것보다, 다른 물체로 바꿔치기한 게 모델을 더 혼란스럽게 만든다는 뜻입니다.
📌 5.3 태스크 형식 개입 (Task-Formulation Interventions)
[실험 설계]
- Yes/No → Yes/No/UnKnown
- 이미지에서 가장 눈에 띄눈 물체 나열 - Open generation
[결과]
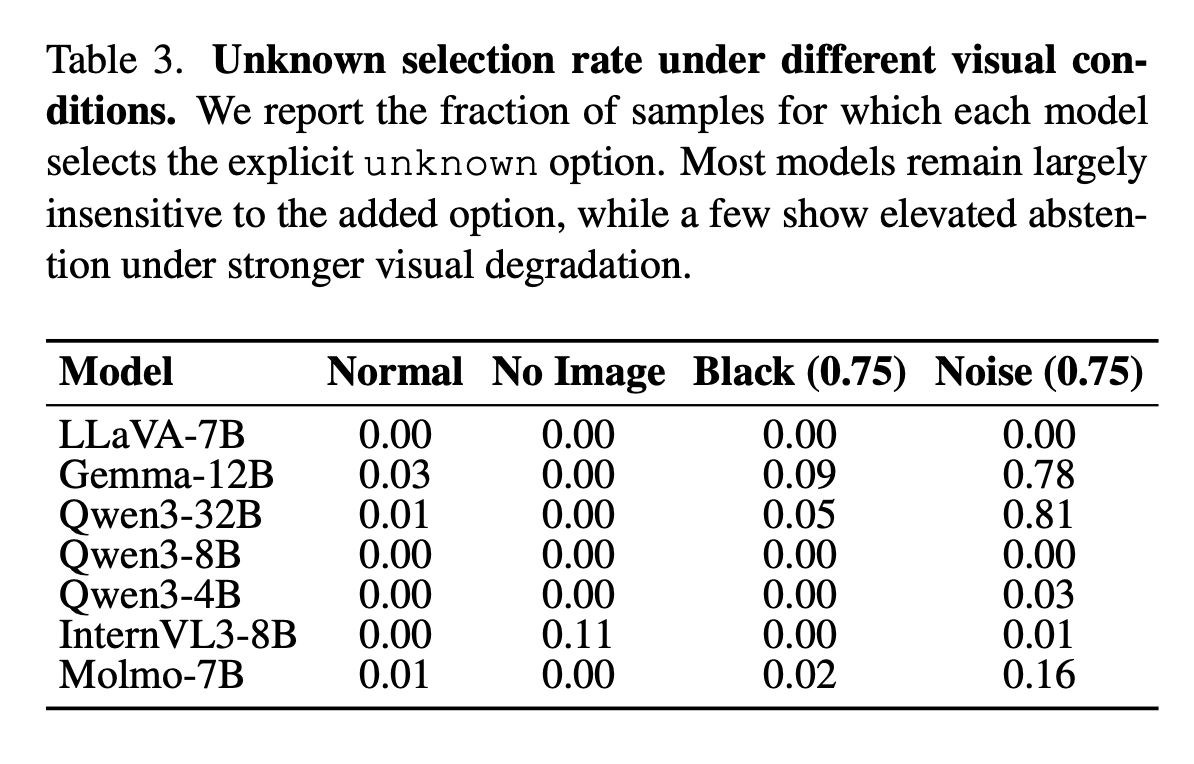
- Unknown 추가
Unknown Rate 분석 결과, 모델들은 시각 증거가 약화되었을 때 불확실성을 인식하는 능력이 제한적임.
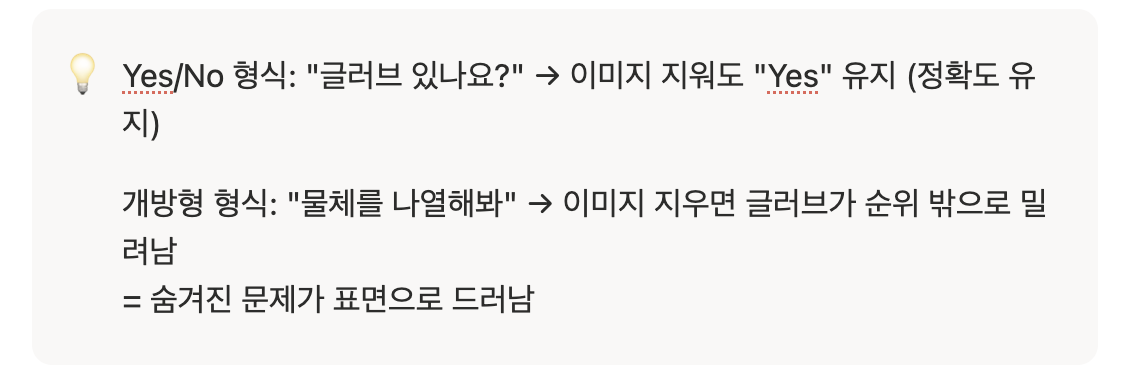
이미지가 조작되어도 모델은 "모르겠음" 대신 여전히 Yes/No 중 하나를 자신 있게 선택하는 경향이 있다
- Open-Generation
정답 개체 순위, MRR은 이미지 조작하에 민감하게 저하
이미지 조작을 했을 때 순위가 크게 떨어지면 이미지를 보고 있었다는 의미/ 순위가 크게 변하지 않는다면 언어 패턴에 의존하고 있었다는 증거
큰 모델(Qwen3-32B)이 작은 모델보다 Yes/No형식에 강하지만, 개방형 형식에서는 이미지 변화에 둔감함 → 언어 패턴이 더 강하게 존재
📖 Section 6: Representational Analysis
<aside> 💡
모델 내부에서 왜 이미지를 지워도 성능이 유지되는지 설명
</aside>
📌 6.1 레이어별 비전 토큰 기하학 분석 (Layer-wise Analysis of Vision Token Geometry)
💡레이어가 깊어질수록 비전 토큰들이 서로 얼마나 비슷해지는지
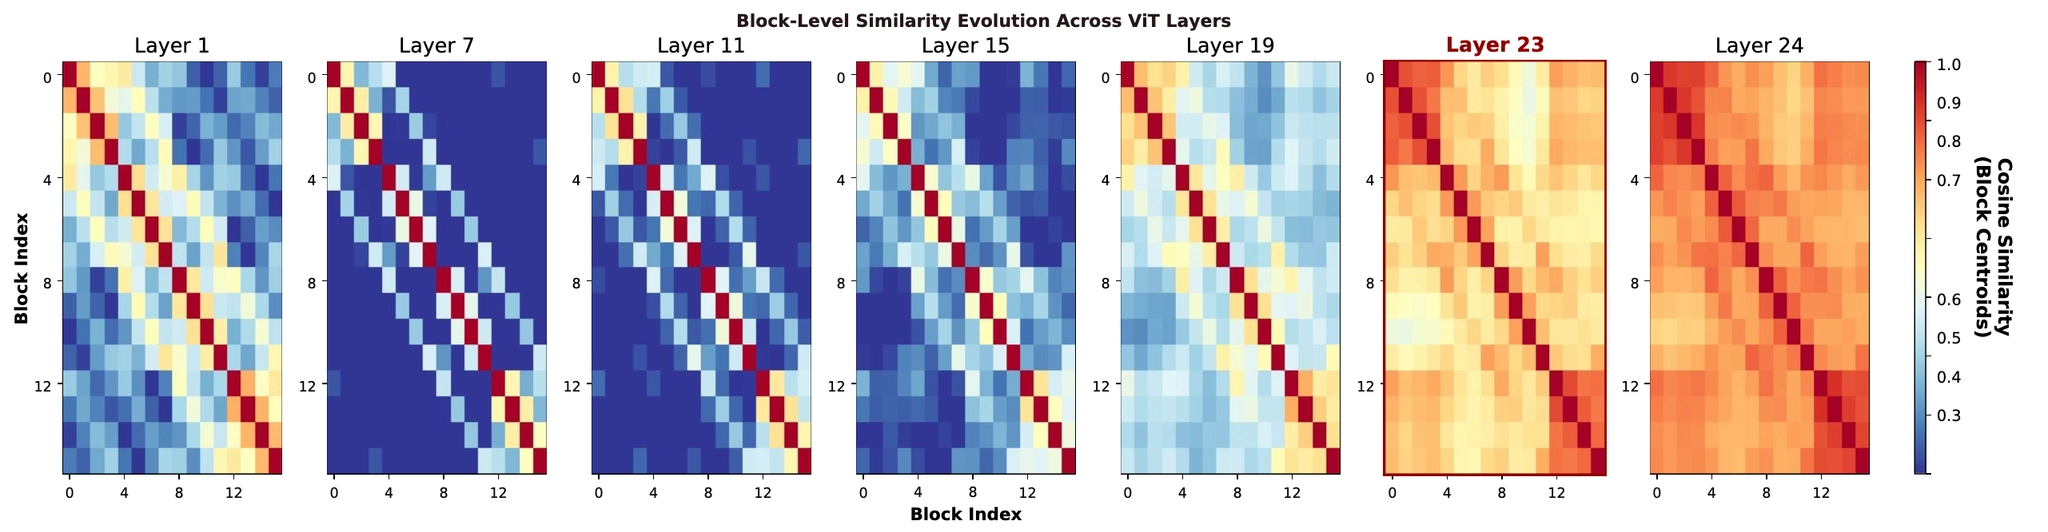
1. token간 cosine similarity
초기 레이어: 글러브 토큰 ≠ 배경 토큰 (유사도 낮음 → 서로 구별 가능) 깊은 레이어: 글러브 토큰 ≈ 배경 토큰 (유사도 높음 → 구별 불가)
2. Kmeans clustering
- 토큰들을 K개 그룹으로 묶었을 때 얼마나 잘 나뉘는지
초기 레이어: "글러브 영역" / "배경" / "사람" 등 공간적으로 잘 분리됨 깊은 레이어: 모든 토큰이 비슷해져서 클러스터 구분이 불분명해짐
3. Effecitive Rank
비전 토큰 행렬이 실질적으로 몇 차원의 정보를 담고 있는지를 측정
유효 랭크가 높다 = 토큰들이 다양하고 풍부한 정보를 담고 있다 유효 랭크가 낮다 = 토큰들이 거의 비슷한 정보만 담고 있다 (균질화)
📌 6.2 깊이가 깊어질수록 공간 판별력이 약화된다 (Spatial Discriminability Degrades with Depth)
- 레이어별 분석 결과, 더 깊은 레이어에서 비전 토큰들 간의 유사성이 증가하는 현상
- 초기 레이어에는 글러브/배경 등의 위치 정보가 살아있으나, 레이어를 거칠수록 공간적 구분이 사라지고 모두 토큰이 비슷한 벡터로 수렴

Entity Swap이 더 잘 드러나는 이유
앞서 EntitySwap이 No-image보다 "Yes" 쪽으로 더 치우쳐 있다는 발견
No-image: 비전 토큰 자체가 없음 → 모델이 "뭔가 이상하다" 인식 EntitySwap: 비전 토큰은 있지만 깊은 레이어에서 균질화됨 → 원래 글러브가 있던 자리와 새 물체의 토큰이 비슷해져서 → 모델이 "글러브가 있는 것처럼" 착각
즉 이미지가 아예 없는 것보다, 다른 물체로 채워져 있는 게 모델을 더 혼란스럽게 만드는 원인이 내부 표현의 균질화 때문이다.
📖 Section 7: Discussion — 핵심 메시지 2가지
7.1 VLM의 시각 의존은 "얕다" (Visual Reliance is Shallow)
VLM은 시각 입력에 의존하기는 하지만, 그 의존은 세밀한 공간 증거보다는 거친 시각 단서, 언어적 패턴, 표현의 중복성에 기반합니다.
한 마디로 — 모델이 이미지를 "보긴 보는데, 겉만 훑는다"는 겁니다.
깊게 보는 게 아니라: "글러브의 정확한 위치, 형태를 인식" 얕게 보는 것: "야구 장면이구나 → 글러브쯤 있겠지"
섹션 5, 6의 실험들이 이걸 여러 각도에서 증명했습니다. 이미지를 지워도 성능이 유지되고, 내부 토큰도 레이어가 깊어질수록 균질화된다는 결과 모두가 이 "얕은 의존"을 가리킵니다.
7.2 현재 벤치마크는 이 문제를 못 잡아낸다 (Current Benchmarks Fail to Capture This)
벤치마크 정확도와 실제 시각 근거 능력 사이의 간극은 VLM 평가의 핵심 문제로 간주되어야 하며, 더 진단적인 방식으로 모델 능력을 평가하도록 동기를 부여합니다.
현재 벤치마크(특히 POPE 같은 Yes/No 형식)의 문제:
- 이진 선택지 → 언어 패턴만으로도 높은 점수 가능
- 정확도만 측정 → 내부 확신 변화, 순위 변화는 안 보임
- 전체 이미지 기준 → 개체 수준 민감도는 안 잡힘
따라서 논문이 제안하는 방향은 "정확도 하나만 보지 말고, 개입 실험 + 개방형 생성 + Decision Margin 같은 다중 진단 지표를 함께 써라"입니다.
📖 Section 8: Conclusion & Future Work
결론 요약
현재 VLM 벤치마크는 세밀한 시각적 근거 능력을 신뢰할 수 있게 평가하기에 충분하지 않습니다. arXiv
논문 전체를 세 줄로 압축하면:
이미지를 망가뜨려도 벤치마크 점수가 안 떨어진다 **(관찰)**모델 내부에서 공간 정보가 레이어를 거치며 사라진다 **(이유)**따라서 현재 벤치마크는 시각 이해를 과대평가하고 있다 (결론)
Future Work — 앞으로 뭘 해야 하나
논문이 제시하는 후속 연구 방향 세 가지:
① 더 나은 벤치마크 설계 Yes/No 형식에서 벗어나, 개체 수준 개입이나 개방형 생성처럼 언어 패턴으로 찍기 어려운 평가 형식이 필요합니다.
② 표현 수준 개선 연구 레이어가 깊어질수록 공간 정보가 사라지는 균질화 문제를 어떻게 해결할지 — 훈련 방식이나 아키텍처 차원의 연구가 필요합니다.
③ 진단 프레임워크 확장 이 논문의 다중 수준 개입 프레임워크를 더 다양한 태스크(VQA, 캡셔닝, 추론 등)에 적용해 일반화 여부를 검증해야 합니다.